質問を分け、根拠をつなぐAI検索。
EarlySearch製品に適用 · 改善中
検索結果の要約にとどまらず、質問を複数の方向から調べ、回答の引用や数値を再確認する技術を作ります。
- 1質問を分解
- 2Web検索・本文を読む
- 3回答を生成
- 4引用・数値を照合
検索、生成、検証を別々の段階として扱います。
クイック回答は必要な資料を探して短く整理し、詳細リサーチは小さな質問を作って複数の方向から調べます。回答後はコードが引用番号の範囲、段落ごとの引用の有無、集めた根拠に数値があるかを検査します。
技術を詳しく見る +
検査結果には問題のある段落、リスト、表の位置を記録します。回答全体を書き直すのではなく、必要な範囲を見直せる構造です。
数値が一致し出典がつながっても、意味の正しさまでは保証しません。資料の信頼性、単位、時点、文脈を合わせて確認する方法を研究します。
次の課題
出典間の矛盾の判断、古い資料と新しい資料の区別、長い調査の根拠を最後まで追う方法を改善します。
ファイル形式を超えた文書の構造と配置。
EarlyOffice製品に適用 · 精度改善中
Hangul・Word文書、スプレッドシート、プレゼンテーション、PDFを扱う製品の中で、形式解釈、編集モデル、フォントと配置計算を研究します。
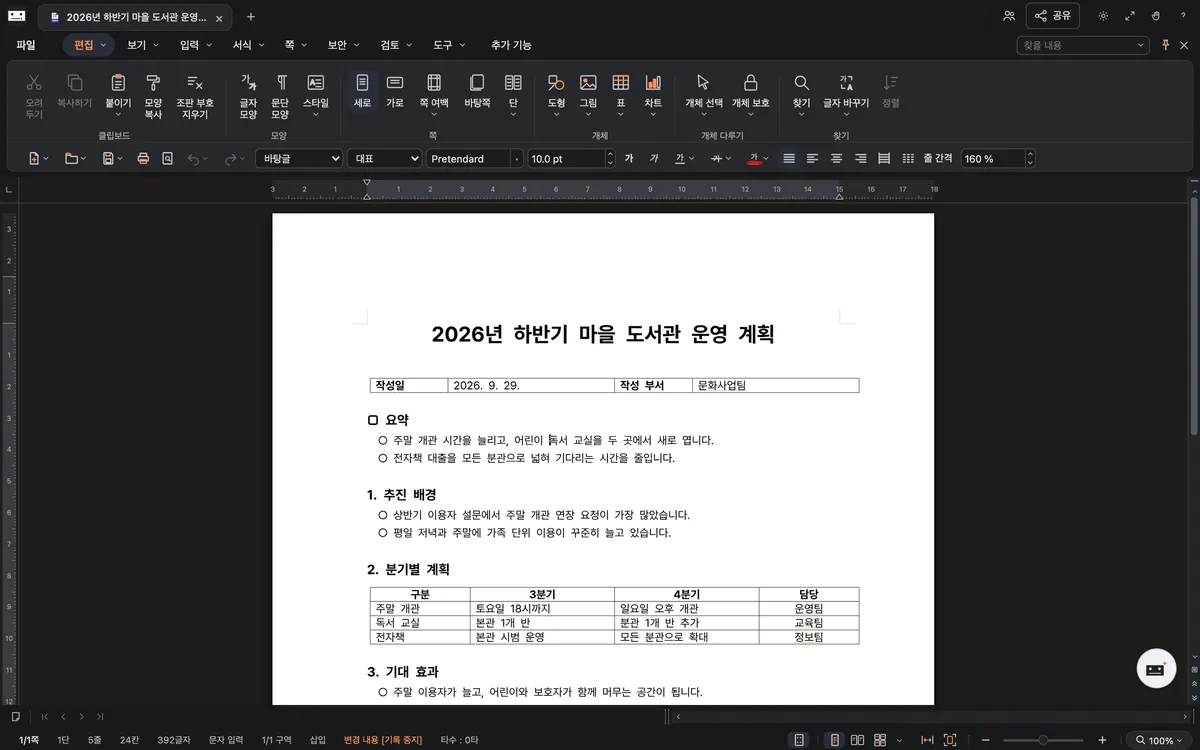 文書エンジンを使ったEarlyOfficeの実際の画面
- 1ファイル解釈
- 2共通文書モデル
- 3編集・配置計算
- 4画面・PDF出力
文書を読む技術と、文書らしく描く技術。
テキスト抽出だけでは表、改ページ、数式、画像の位置を保てません。文書構造と編集状態を管理し、フォントファイルの実情報で配置を計算します。WebとデスクトップでRustコアを共有し、プラットフォームの差を減らします。
技術を詳しく見る +
組版では整数の文書単位と一貫した丸め規則を使用します。計算した描画情報を画面とPDF出力につなぎ、原本文書の出力と比較して差を追います。
表計算、スライドオブジェクト、PDF処理など種類別のエンジンも同じ製品体験につなぎます。機能と再現範囲は形式ごとに異なり、すべてのファイルの完全互換を意味しません。
次の課題
複雑な表の改ページ、フォント代替、オブジェクト配置、形式間変換の損失を減らすことが継続課題です。
文章を書くAIから、文書を編集するAIへ。
EarlyOffice試作版 · 研究中
段落と表を理解し、必要な箇所を編集し、配置まで確認するツール型文書AIを研究します。
- 1文書構造を読む
- 2ツールで編集を提案
- 3配置を確認
- 4承認・元に戻す
文書のどこをどう変えたか記録します。
文書全体をテキストで渡す代わりに、意味のまとまりで読み書きするツールを提供します。変更位置を特定し、古い要求と最新の編集が衝突しないか確認します。変更を提案として残し、検討できる流れを作っています。
技術を詳しく見る +
段落と表の安定した識別子を文書の版情報と併用します。編集後に組版を確認し、一つの要求による変更をまとめて戻す構造を実験します。
文書編集コアとAIツールをつないだ開発・試作の範囲です。説明した全工程がすべての製品画面で一般提供されているわけではありません。
次の課題
長文書の必要な文脈選択、表や配置の修正後の確認、利用者の意図を保つ編集を研究します。
Webとアプリが共に使うグラフィック編集エンジン。
EarlyDesign製品に適用 · 互換範囲を拡大中
テンプレート、写真、ベクターイラスト、画面設計を別々に作らず、レイヤーとオブジェクトを扱うエンジンを自作してブラウザーとネイティブアプリで共有します。
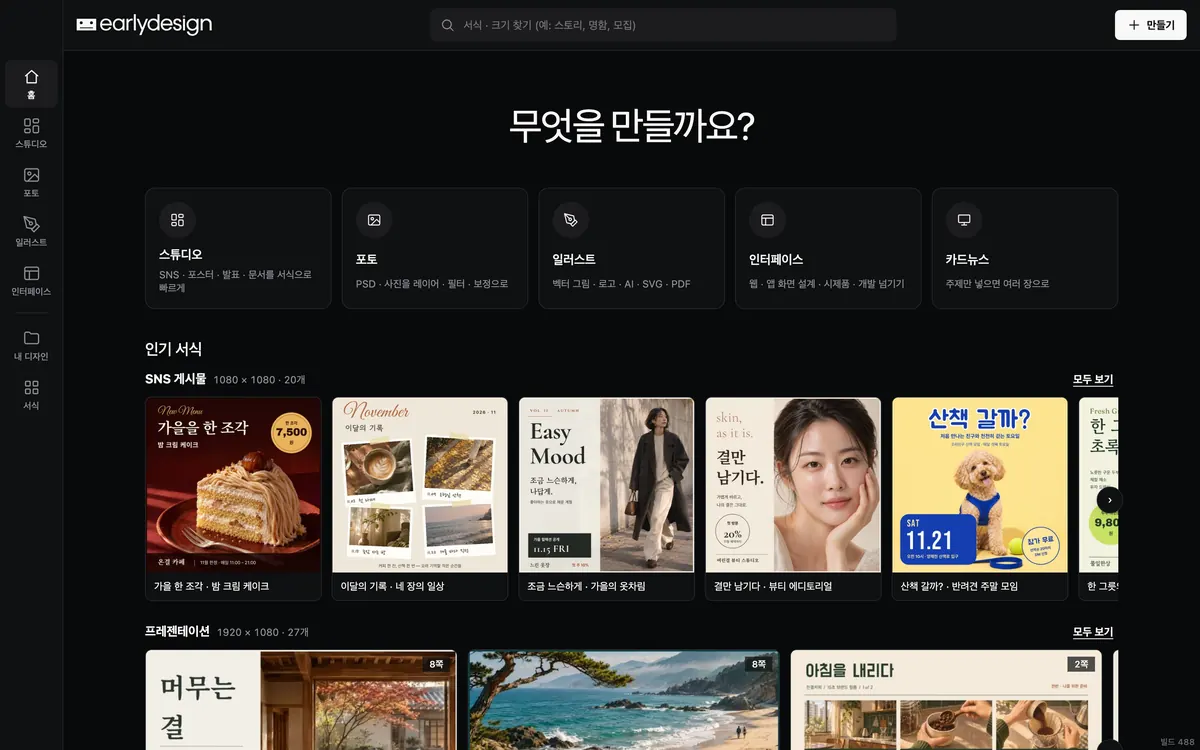 グラフィックエンジンを使ったEarlyDesignの実際のホーム画面
- 1元ファイルを読む
- 2レイヤー・オブジェクトモデル
- 3エンジンで描画
- 4元形式で保存
画面が違っても、編集は同じエンジンで。
スタジオ、フォト、イラスト、インターフェースの文書状態と編集命令はRust製エンジンが担当します。ブラウザーはWebAssembly、iPhone・iPad・Androidアプリは同じコアをネイティブ接続で呼び、同じ文書を同じ方法で描きます。一つの利用者操作に属する複数工程を、一回の取り消しにまとめます。
技術を詳しく見る +
写真の空白を埋める消去ツールは、公開ライセンスのインペインティングモデルをブラウザー内で実行します。写真は外へ送らず、モデルが使えなければエンジンの補完方式へ戻ります。
画像のベクター化では、知覚色空間での色のグループ化、角や小片の扱いを自ら実装しました。原本と再描画の色差を測る評価ツールで、設定ごとに比較し改善します。
編集命令は名前と引数を定めた命令群として公開しています。AI補助はMCPとブラウザーのWebMCPで同じ命令を使いますが、接続は初期状態で無効、文書変更は利用者の確認後に実行します。
次の課題
レイヤー効果とベクター固有機能の再現を広げ、大文書のメモリと端末内モデルの品質・速度を両立する方法を改善します。
画像と言語をつなぐモデル研究。
画像モデル研究追加学習 · 実験中
画像と説明文のデータ準備、画像モデルの追加学習、自然言語の要求を画像生成につなぐ流れを研究します。
- 1画像・説明文を準備
- 2追加学習
- 3条件付き画像生成
- 4結果を比較
良い結果はデータと生成過程から。
画像から説明文を作る前処理と学習資料の構成を扱い、既存画像モデルを目的に合わせる追加学習を実験します。別途、韓国語の会話を生成要求に変換し、画像生成につなぐ試作も作っています。
技術を詳しく見る +
画像と説明文を対応させるキャプション工程、LoRAの追加学習成果物、会話からプロンプトを作り生成エンジンに渡す実装を基に研究します。既存モデルの活用・追加学習と基盤モデルの独自開発は区別します。
学習を実行したことと、品質が向上したという結論は別です。学習中モデルの性能や汎用性を断定せず、同条件の生成結果とデータの影響を比較します。
次の課題
説明文と画像の整合、意図した視覚特徴の維持、学習資料の偏りと権利、要求した場面の一貫した表現を調べます。
会話の後も、任せた仕事を続けるエージェント。
EarlyBot開発版 · 実行範囲を拡大中
要求を作業へ変え、実行状態を保存し、必要な承認を得て結果を確認する長期作業構造を開発します。
- 1目標・計画
- 2承認・ツール実行
- 3状態保存・再開
- 4結果確認・通知
回答と実行を区別します。
EarlyBotは会話画面とは別に実行機と予約状態を管理します。サーバーが動作していればタブを閉じても予約を処理し、接続待ち、実行、確認、完了などを記録します。モデルの提案と実ツールの実行権限を分けることが重要です。
技術を詳しく見る +
作業、予定、実行履歴、結果、通知を永続保存し、重複実行を制限します。アプリ・ブラウザー・端末の経路をつなぐ際は、作業に属する承認と結果を確認する構造にします。
確認済みの開発環境と対応ツールの範囲を区別します。すべての外部業務の自律完了や、PC電源が切れていても動くとは主張しません。
次の課題
中断からの再開、複数ツールの結果検証、失敗からの回復、利用者が介入すべき時点を精密にしていきます。
説明し直さなくてよい文脈へ。
EarlyBot開発実装 · 評価を拡大中
好み、決定、過去の作業を出典と時点のある記憶に整理し、新しい要求に必要な文脈を探してつなぎます。
- 1原文を記録
- 2出典・時点を整理
- 3関連記憶を検索
- 4修正・除外を反映
記憶には内容だけでなく出典と変更履歴も必要です。
原文検索の索引と構造化した記憶を併用します。後から整理した古い会話が最近の訂正を上書きしないよう発言時点を扱い、利用者が修正・除外した内容を再び持ち込まないよう管理します。
技術を詳しく見る +
新しい会話や作業計画で関連記録を探し、保存原文とAIの解釈を分けます。検索候補が出ても、所有者と有効状態を保存先で再確認する構造です。
記憶は新しい実行権限ではありません。過去の発言を覚えていることを、新規作業の承認の代わりにしません。現在の開発範囲を商用の複数利用者隔離完了とは表現しません。
次の課題
古い記憶と最近の決定の優先順位、検索の関連性、誤記憶を直す体験、長期精度の評価を研究します。
古い圧縮形式から、安全なファイル処理まで。
EarlyZip開発版に適用 · 検証を拡大中
ALZ・EGGと韓国語ファイル名の解釈、プラットフォーム別圧縮処理、失敗でファイルを壊さない保存方式を開発します。
- 1形式・名前を解釈
- 2経路・衝突を検査
- 3解凍・完全性確認
- 4完了結果を反映
開けた後も、最後まで正しく扱います。
韓国語環境の古い文字コードと圧縮形式は、拡張子の認識だけでは解決しません。共通エンジンと各環境の実装をつなぎ、フォルダー外への経路、名前の衝突、不完全な出力を検査します。圧縮ファイルは端末内で処理します。
技術を詳しく見る +
正常な資料に加え、破損・切断ファイルも繰り返し入力し、クラッシュ、停止、過剰な資源利用、指定外への書き込みをファジングと回帰試験で確認します。対応範囲と検証済みの変種は区別します。
小さなファイルが多い作業のバッファー再利用、同期、並列処理も改善対象です。環境や条件が異なる測定を、一つの速度優位として一般化しません。
次の課題
珍しい圧縮形式の変種、暗号化・分割ファイルの環境別範囲、モバイル保存領域とバックグラウンド処理の制約を検証し続けます。
大きなモデルを限られた資源で動かす方法。
モデル・文書AI研究開発環境で検証 · 性能研究中
ローカル文書AIに向け、モデルデータとメモリの配置を研究します。モデル品質とは別に実行資源を扱います。
- 1モデル構造を確認
- 2メモリ予算を配置
- 3SSD・RAM・GPUを活用
- 4同条件で比較
推論の速度とメモリは一緒に見ます。
SSD、RAM、GPUメモリにモデルデータを分散し、必要な演算につなぐ実行構造を実験します。全モデル構造を維持して静的配置と動的エキスパートキャッシュを比較し、初回回答時間と入出力コストを観察します。
技術を詳しく見る +
文書の生成・編集・保存・再読み込みを実エンジンにつなぐ開発検証と、追加学習・実行性能の検証を分けます。特定機器で動いた事実を、全利用者の最低仕様に置き換えません。
動的キャッシュが常に速いわけではありません。基準実行と出力・負荷・条件をそろえて比較し、改善を確認できなかった実験も記録します。
次の課題
メモリ配置による遅延とディスクアクセス、キャッシュ交換方針、機器ごとの安定性、モデル品質をそれぞれ評価します。
画面をつなぎ、実行権限を分ける技術。
EarlyRemote · EarlyBot開発接続を検証 · 範囲拡大中
遠隔映像と入力の接続、閲覧と操作の分離、AI作業が実機を扱う時の承認と状態管理を研究します。
- 1画面取得・エンコード
- 2映像・入力を送信
- 3操作権を確認
- 4接続断に対応
接続と操作できる権限は別です。
画面は映像で、キーボード・マウス入力は別経路で送ります。閲覧セッションと操作権を分け、切断時のキー・ボタン解除など端末状態も扱います。エージェントのファイル・アプリ作業も許可された範囲につなぐ方向で開発します。
技術を詳しく見る +
信頼した開発機器間の実際の映像・入力経路を確認し、ファイル処理では承認計画と結果検証を結ぶ構造を実装しました。ローカル接続の確認を一般インターネットやゲーム性能の検証へ広げません。
画面取得・入力の権限、ホストOSの制約、作業中断と復旧は別々の問題です。モデルの計画と実機での実行を分けて観察できる流れを扱います。
次の課題
接続環境別の遅延と画質、長時間接続の安定性、OS別の権限・入力差、遠隔作業の検証範囲を広げます。
技術の基準は、
使う人にあります。
- データから製品まで直接つなぎます。
- 学習資料、モデル実行、エンジン、利用体験を一つの課題として扱います。
- 実際の作業で確かめます。
- 生成文書の再読み込み、解凍ファイルの完全性、再描画した画像と原本の差、実行した作業の結果など、実際の成果物を確認します。
- 開発と評価を一緒に記録します。
- 学習の実行と品質向上、開発環境での検証と製品への適用を区別します。
